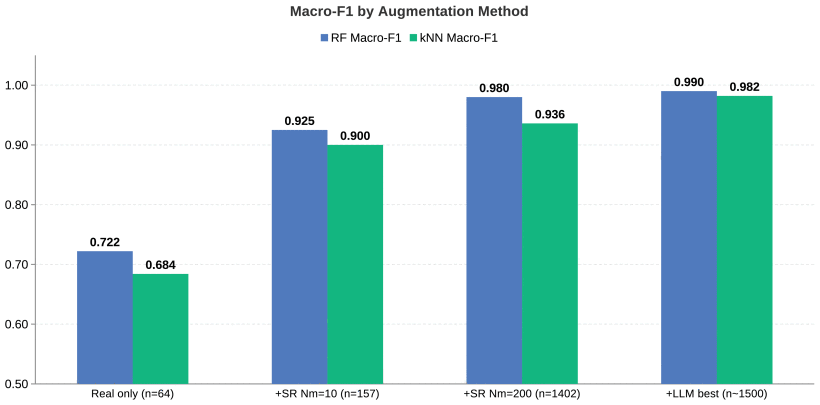
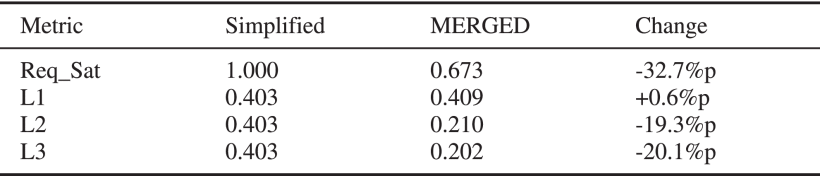
부제: Camp2Vec에서 MuCamp, 그리고 MuCamp2까지
주제: CTI, ATT&CK, Group Attribution, TTP Sequence, LLM, AEP Validation
들어가며
최근 내가 1저자로 참여한 논문 “MuCamp2: Generating Validated Cyber Campaign Variants via Constrained LLMs for Group Attribution”이 IEEE Access에 게재되었다.
논문 링크: https://ieeexplore.ieee.org/document/11552376
DOI: 10.1109/ACCESS.2026.3700808
GitHub: https://github.com/cyailab/MuCamp2
솔직히 아직도 IEEE Xplore나 Google Scholar 같은 곳에 논문 제목이나 내 이름을 검색했을 때 결과가 나오는 게 조금 신기하다. 논문을 쓰는 과정에서는 실험, 수식, 표, 리뷰 대응, 문장 수정 같은 것들에 치여서 잘 체감이 안 됐는데, 막상 검색 결과에 내 이름이 1저자로 걸려 있는 걸 보면 “아, 이게 진짜 기록으로 남는구나”라는 느낌이 든다.
그리고 논문만 올라간 것이 아니라, MuCamp2 GitHub repository도 함께 공개되어 있다. 논문이 연구의 주장과 결과를 정리한 문서라면, GitHub는 그 연구가 실제로 어떤 pipeline과 script, data structure로 구현되었는지 보여주는 산출물이다.
그래서 이 글에서는 논문 내용뿐 아니라, Camp2Vec → MuCamp → MuCamp2로 이어지는 연구 흐름과 GitHub에 공개된 구현 구조까지 같이 정리해보려고 한다.
IEEE Xplore에 등록된 MuCamp2 논문 페이지
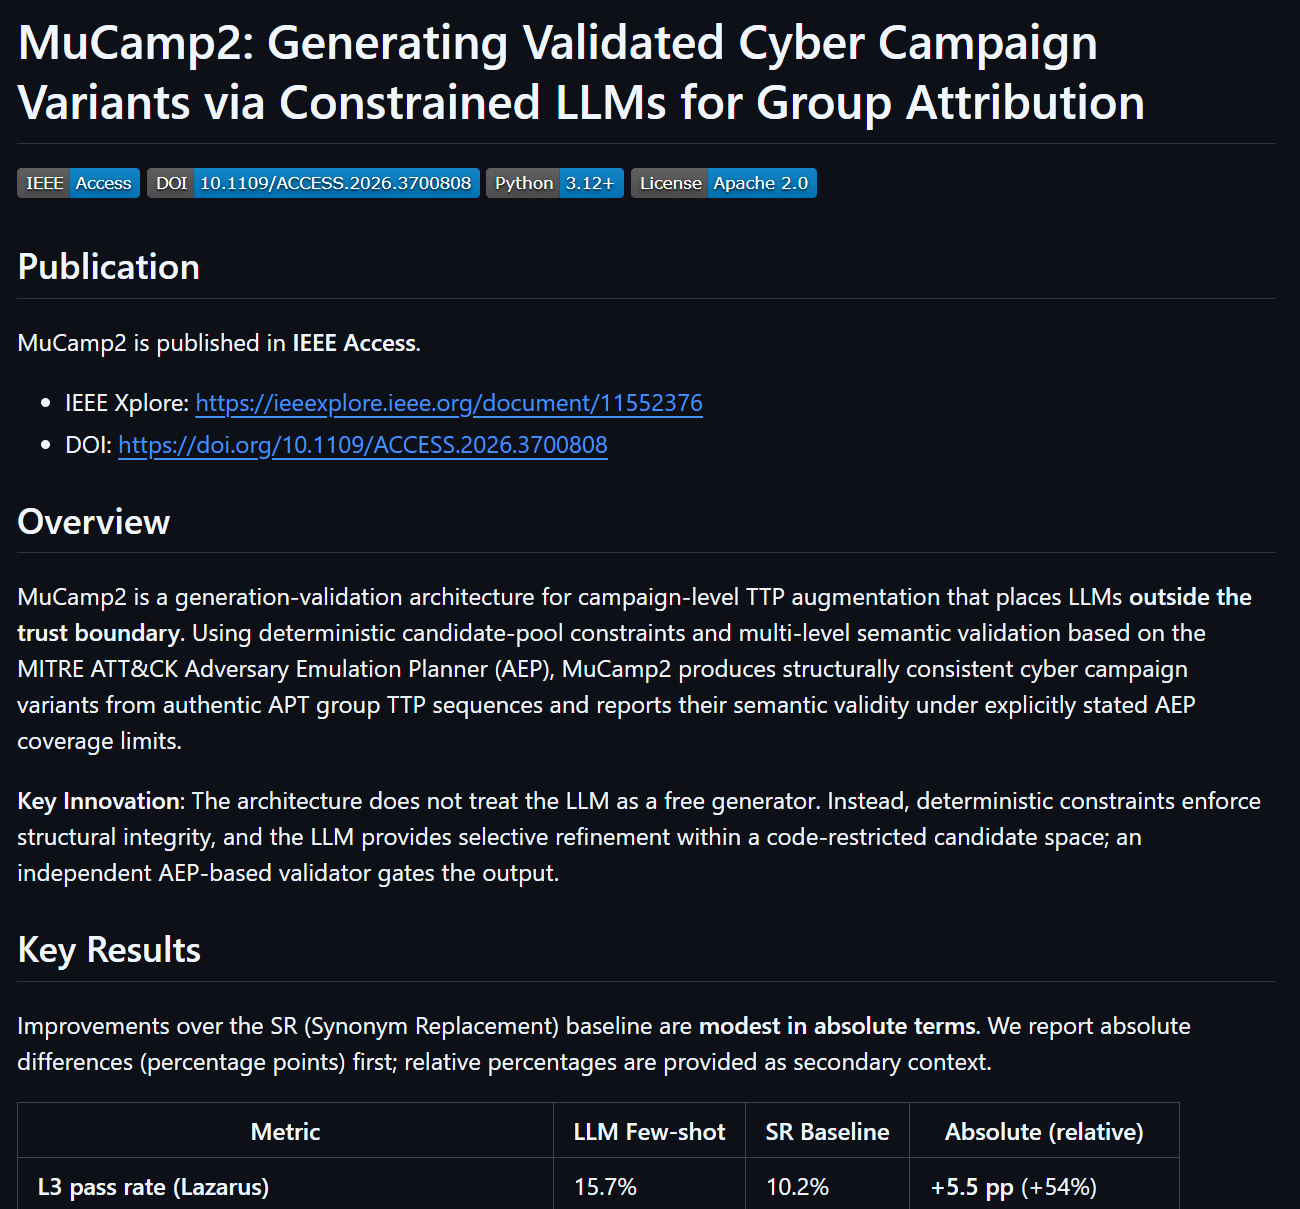
MuCamp2 GitHub repository. 논문에서 제안한 generation-validation pipeline과 실험 스크립트, GUI demo를 함께 공개했다.
이 글은 논문을 단순히 요약하는 글은 아니다.
논문의 문제의식, 연구가 흘러간 과정, 왜 기존 MuCamp의 SR 방식에서 LLM으로 넘어가려 했는지, 그리고 최종적으로 왜 AEP 기반 L1/L2/L3 validation이 필요해졌는지를 1저자 관점에서 정리하는 글이다.
먼저 한 문장으로 요약하면 이렇다.
MuCamp2는 group attribution을 위한 TTP sequence augmentation에서 SR을 LLM으로 대체하려는 시도에서 출발했고, 그 과정에서 “LLM이 만든 variant가 정말 좋은 variant인지 어떻게 판단할 것인가”라는 문제를 AEP 기반 multi-level validation으로 다룬 연구다.
중요한 건 “LLM을 썼다”가 아니다.
사실 MuCamp2를 시작할 때 LLM을 쓰는 것 자체는 꽤 자연스러운 선택이었다. 기존 MuCamp는 TTP Synonym Replacement, 즉 SR 기반으로 cyber campaign variant를 만들었다. 그렇다면 다음 단계로 “SR 대신 LLM을 사용하면 더 자연스럽고 품질 좋은 variant가 나오지 않을까?”라는 가설을 세우는 것은 자연스러웠다.
하지만 연구를 진행하면서 핵심 질문은 조금 달라졌다.
처음 질문은 이거였다.
SR 대신 LLM을 넣으면 더 좋은 TTP variant가 나올까?
그런데 곧 더 중요한 질문이 생겼다.
좋은 TTP variant란 무엇인가?
그리고 LLM이 만든 variant가 정말 더 좋다는 것을 어떻게 증명할 것인가?
MuCamp2에서 AEP를 도입하고, L1/L2/L3 validation을 설계한 이유가 여기에 있다.
1. 이 연구의 계보: Camp2Vec → MuCamp → MuCamp2
MuCamp2를 이해하려면 이 연구를 단독으로 보는 것보다, 앞선 연구 흐름을 같이 보는 편이 좋다.
이 흐름은 크게 세 단계로 볼 수 있다.
Camp2Vec
    ↓
MuCamp
    ↓
MuCamp2
각 단계의 질문은 조금씩 다르다.
Camp2Vec의 질문은 “cyber campaign을 어떻게 표현할 것인가”에 가까웠다.
MuCamp의 질문은 “표현할 수 있다면, 부족한 campaign data를 어떻게 늘릴 것인가”였다.
MuCamp2의 질문은 “LLM으로 더 나은 variant를 만들 수 있다면, 그 품질을 어떻게 판단할 것인가”로 이동했다.
즉 이 흐름은 단순히 방법론이 복잡해진 과정이 아니다.
더 정확히는 연구 질문이 다음과 같이 이동한 과정이다.
Representation
→ Augmentation
→ Quality Validation
Camp2Vec: campaign을 표현하는 문제
Camp2Vec는 campaign-level TTP를 벡터로 표현하려는 연구였다. Cyber campaign을 ATT&CK technique들의 조합으로 보고, campaign과 technique의 관계를 document와 word의 관계처럼 모델링한다. 이렇게 하면 각 campaign을 numerical vector로 표현할 수 있고, 이를 attack group analysis에 사용할 수 있다.
여기서 중요한 문제의식은 데이터 부족이다.
APT group attribution에서는 많은 campaign sample이 필요하지만, 공개 CTI report에서 추출할 수 있는 campaign-level TTP data는 제한적이다. Deep learning처럼 많은 데이터를 요구하는 복잡한 모델을 쓰기 어려운 상황에서, Camp2Vec는 lightweight statistics-based embedding으로 campaign representation 문제를 다루었다.
하지만 representation만으로는 데이터 부족 문제가 완전히 해결되지 않는다.
Campaign을 벡터로 표현할 수 있다고 해도, 학습과 평가에 사용할 campaign sample 자체가 부족하면 attribution model은 여전히 제한된다.
이 지점에서 MuCamp가 등장한다.
MuCamp: campaign data를 늘리는 문제
MuCamp의 질문은 이렇다.
campaign-level TTP sequence가 부족하다면, 원본 campaign의 의미를 보존하는 variant를 만들어 attribution data를 보강할 수 있지 않을까?
MuCamp는 이 문제를 TTP Synonym Replacement, 즉 SR 방식으로 풀었다. 같은 tactic 안에서 technique을 교체해 원본 campaign과 유사하지만 조금 다른 variant를 만드는 방식이다.
이 방식은 단순하고 해석 가능하다. 어떤 technique이 어떤 technique으로 바뀌었는지 추적할 수 있고, ATT&CK tactic이라는 domain knowledge를 직접 활용한다. 따라서 group attribution을 위한 data augmentation의 출발점으로는 꽤 자연스럽다.
하지만 SR에는 한계가 있다.
같은 tactic에 속한 technique이라고 해서 항상 서로 대체 가능한 것은 아니다. Campaign sequence는 단순히 tactic label의 배열이 아니라, 앞뒤 technique 사이의 맥락과 capability dependency를 포함한다.
따라서 SR은 구조적으로 단순하고 재현 가능하지만, variant quality 관점에서는 한계가 생긴다.
MuCamp2: generated variant의 품질을 판단하는 문제
MuCamp2는 여기서 출발했다.
처음 질문은 비교적 단순했다.
SR 대신 LLM을 사용하면 더 자연스럽고 품질 좋은 campaign variant를 만들 수 있지 않을까?
LLM은 주변 sequence context를 볼 수 있고, 단순 random replacement보다 더 자연스러운 technique을 선택할 수 있을 것처럼 보인다. 그래서 MuCamp2에서는 SR을 LLM 기반 mutation으로 대체하는 방향을 생각했다.
하지만 연구를 진행하면서 핵심 질문은 바뀌었다.
LLM을 넣으면 더 좋은 variant가 나오는가?
이 질문은 곧 다음 질문으로 바뀐다.
좋은 variant란 무엇인가?
그리고 LLM이 만든 variant가 정말 좋은지 어떻게 판단할 것인가?
이 질문 때문에 AEP를 도입하게 되었고, L1/L2/L3 validation을 설계하게 되었다.
결국 Camp2Vec, MuCamp, MuCamp2의 흐름은 이렇게 정리할 수 있다.
Camp2Vec:
cyber campaign을 ATT&CK 기반 vector로 표현한다.

MuCamp:
표현 가능한 campaign data가 부족하므로,
SR 기반으로 campaign variant를 생성한다.

MuCamp2:
SR 대신 LLM을 사용해 더 나은 variant를 기대하되,
그 variant의 품질을 AEP 기반 L1/L2/L3 validation으로 검증한다.
이렇게 보면 MuCamp2의 핵심이 더 선명해진다.
MuCamp2는 단순히 “LLM을 사용한 MuCamp”가 아니다.
Camp2Vec에서 시작된 campaign representation 문제, MuCamp에서 제기된 campaign augmentation 문제를 이어받아, LLM 기반 augmentation에서 variant quality를 어떻게 정의하고 검증할 것인가로 연구 질문을 확장한 작업이다.
2. 출발점: MuCamp는 왜 campaign variant를 만들었나
APT group attribution은 특정 cyber campaign이 어떤 threat group과 관련되어 있는지 추정하는 문제다.
이때 단일 IoC만으로 group attribution을 수행하기는 어렵다. IP, domain, hash, C2 infrastructure는 공격자가 비교적 쉽게 바꿀 수 있다.
반면 TTP는 상대적으로 안정적인 behavioral pattern을 제공한다.
공격자가 어떤 방식으로 초기 실행을 하고, 권한을 유지하고, 방어 회피를 수행하고, 내부 정찰을 거쳐, 최종적으로 collection, exfiltration, impact에 도달하는지는 group-level behavior를 반영할 수 있다.
그래서 MuCamp는 cyber campaign을 TTP sequence로 보고, group attribution을 위한 data augmentation을 수행했다.
문제는 데이터 부족이다.
공개 CTI report에서 campaign-level TTP sequence를 추출하면, 생각보다 usable sample이 많지 않다. MuCamp2에서도 Lazarus와 MenuPass 관련 report 153개를 수집했지만, ATT&CK v18 mapping, excluded tactic filtering, minimum length filtering 등을 거친 뒤 최종 seed sequence는 93개만 남았다.
Lazarus: 106 reports → 63 seed sequences
MenuPass: 47 reports → 30 seed sequences
Total: 153 reports → 93 seed sequences
이 정도 규모에서는 attribution model이 실제 group behavior를 학습하기보다, 관측된 report pattern에 과적합될 가능성이 있다.
따라서 campaign-level TTP augmentation이 필요해진다.
MuCamp는 이 문제를 SR, 즉 synonym replacement 방식으로 풀었다.
3. MuCamp의 SR 방식: 단순하지만 해석 가능한 augmentation
MuCamp의 핵심 아이디어는 비교적 직관적이다.
Campaign을 TTP sequence로 보고, 특정 position의 technique을 같은 tactic 안의 다른 technique으로 교체한다.
예를 들어 seed sequence가 다음과 같다고 하자.
Execution → Persistence → Defense Evasion → Discovery → Collection → Exfiltration
여기서 Persistence 위치에 있는 technique을 같은 Persistence tactic에 속한 다른 technique으로 바꾸면, 전체 tactic-level 흐름은 유지하면서 원본 campaign과 유사한 variant를 만들 수 있다.
이 방식은 장점이 분명하다.
1. 구조가 단순하다.
2. 재현 가능하다.
3. 어떤 technique이 어떤 technique으로 바뀌었는지 해석 가능하다.
4. ATT&CK tactic이라는 domain knowledge를 직접 반영한다.
5. 원본 campaign의 strategic goal을 보존하는 방향으로 설계할 수 있다.
즉 SR은 campaign augmentation을 위한 꽤 좋은 출발점이었다.
하지만 SR에는 한계도 있다.
같은 tactic에 속한다고 해서 두 technique이 항상 서로 대체 가능한 것은 아니다. ATT&CK tactic은 높은 수준의 행위 목적을 나타내지만, 실제 campaign sequence에서는 technique 사이의 전후 관계가 중요하다.
어떤 technique은 특정 privilege가 확보된 뒤에야 자연스럽고, 어떤 technique은 lateral movement가 이미 발생한 뒤에야 말이 되며, 어떤 technique은 앞 단계에서 credential이나 tool delivery가 확보되었을 때 더 자연스럽다.
즉 campaign sequence는 단순히 tactic label의 배열이 아니다.
표면적으로는 같은 tactic 안에서 교체했더라도, 실제 operational flow 관점에서는 어색한 variant가 만들어질 수 있다.
이 지점에서 MuCamp2의 출발점이 생겼다.
4. SR 대신 LLM을 넣어보자는 가설
MuCamp2를 시작할 때의 기본 가설은 단순했다.
SR보다 LLM이 더 좋은 campaign variant를 만들 수 있지 않을까?
SR은 같은 tactic 안에서 technique을 교체하지만, 주변 sequence context를 깊게 보지는 않는다. 반면 LLM은 앞뒤 맥락을 보고 더 자연스러운 replacement를 고를 수 있을 것처럼 보인다.
예를 들어 seed sequence가 다음과 같다고 하자.
Initial Access → Execution → Persistence → Privilege Escalation → Defense Evasion → Discovery → Collection → Exfiltration
이때 어떤 position의 technique을 바꿔야 한다면, 단순 SR은 같은 tactic에 속한 후보 중 하나를 고른다. 하지만 LLM은 앞뒤 sequence를 보고 “이 흐름에서는 어떤 technique이 더 자연스러운가”를 선택할 수 있을 것이라고 기대할 수 있다.
이것이 MuCamp2의 초기 가설이었다.
LLM을 넣으면 더 다양한 variant를 만들 수 있고, 단순 SR보다 더 자연스러운 campaign-level TTP sequence를 만들 수 있을 것이라고 봤다.
하지만 여기서 바로 문제가 생긴다.
“더 자연스럽다”는 것을 어떻게 측정할 것인가?
LLM이 만든 sequence가 사람 눈에는 그럴듯해 보일 수 있다. 하지만 그게 실제로 좋은 variant라는 뜻은 아니다.
더 구체적으로는 이런 질문들이 생긴다.
1. downstream group attribution 성능이 오르면 좋은 variant인가?
2. tactic order가 유지되면 좋은 variant인가?
3. 원본 campaign의 goal tactic이 보존되어야 좋은 variant인가?
4. 바뀐 technique이 앞뒤 capability dependency와 맞아야 좋은 variant인가?
5. LLM이 만든 sequence가 다양하면 좋은가,
   아니면 원본 campaign identity를 더 잘 보존해야 좋은가?
이 질문에 답하지 못하면 “LLM이 SR보다 좋다”고 말할 수 없다.
단순히 LLM output이 그럴듯하다고 해서 좋은 variant라고 주장할 수는 없다. 더 위험한 것은 downstream attribution 성능만 보는 것이다.
Synthetic data가 늘어나서 classifier 성능이 올랐다고 해도, 그 성능 향상이 실제 group behavior를 더 잘 학습했기 때문인지, augmentation artifact를 학습했기 때문인지 구분하기 어렵다.
따라서 MuCamp2의 핵심 문제는 점점 명확해졌다.
LLM을 쓰는 것이 문제가 아니라, LLM이 만든 TTP variant의 품질을 어떻게 정의하고 검증할 것인가가 문제였다.
5. “좋은 TTP variant”를 어떻게 정의할 것인가
MuCamp2에서 가장 중요한 고민은 quality definition이었다.
Campaign variant가 좋으려면 최소한 몇 가지 조건을 만족해야 한다.
첫째, 원본 sequence의 기본 구조가 유지되어야 한다.
- Seed sequence와 variant sequence의 길이가 갑자기 달라지거나, 바꾸기로 한 position 외의 technique이 바뀌면 안 된다. 이것은 가장 기본적인 format-level integrity다.
둘째, tactic-level 흐름이 깨지면 안 된다.
- ATT&CK tactic은 campaign의 큰 흐름을 나타낸다. Execution, Persistence, Privilege Escalation, Defense Evasion, Discovery, Lateral Movement, Collection, Exfiltration, Impact 같은 흐름이 완전히 뒤섞이면 campaign variant라고 보기 어렵다.
셋째, goal tactic이 보존되어야 한다.
- MuCamp2에서는 Collection, Exfiltration, Impact를 goal tactic으로 보았다. 이들은 campaign의 전략적 목적과 연결된다. 원본 campaign이 data theft 성격을 갖고 있는데, augmentation 결과에서 Exfiltration이 사라지거나 Impact 중심으로 바뀌면 그것은 원본 campaign의 variant라고 보기 어렵다.
넷째, technique 사이의 dependency가 어느 정도 말이 되어야 한다.
- 어떤 technique은 앞 단계에서 특정 capability가 확보되어야 자연스럽다. 예를 들어 lateral movement와 관련된 technique은 내부 접근, credential, privilege, remote execution context와 관련될 수 있다. 이런 capability chain이 완전히 무시되면, tactic order가 맞더라도 operationally inconsistent한 sequence가 될 수 있다.
그래서 MuCamp2는 variant quality를 한 번에 판단하지 않고, 여러 층으로 나누어 판단했다.
그 결과 나온 것이 L1, L2, L3 validation이다.
6. 왜 AEP를 도입했나
L1/L2/L3를 만들기 위해서는 technique 사이의 정합성을 판단할 기준이 필요했다.
단순히 ATT&CK tactic만 보면 부족하다. 같은 tactic에 속한 technique이라도 전후 관계가 다를 수 있기 때문이다.
그래서 MuCamp2에서는 AEP, 즉 Adversary Emulation Planner를 도입했다.
AEP는 각 ATT&CK technique에 대해 requires/provides 형태의 capability 정보를 제공한다. 간단히 말하면, 어떤 technique이 실행되기 위해 필요한 capability가 무엇이고, 실행 후 어떤 capability를 제공하는지 볼 수 있다.
예를 들어 어떤 technique이 다음과 같은 형태로 표현된다고 하자.
Technique A
requires: user-level execution
provides: local privilege context

Technique B
requires: local privilege context
provides: credential access opportunity
이런 식의 requires/provides 관계를 이용하면, sequence가 단순히 tactic order만 맞는지보다 더 깊은 수준에서 operational consistency를 평가할 수 있다.
물론 AEP가 완전한 ground truth는 아니다.
AEP coverage는 제한적이고, 모든 ATT&CK technique에 대해 완전한 requires/provides mapping이 존재하는 것도 아니다. 따라서 AEP validation은 “절대적 정답”이 아니라 “현재 가능한 operational proxy”에 가깝다.
하지만 MuCamp2에서 중요한 것은 바로 그 proxy를 명시적으로 사용했다는 점이다.
LLM이 만든 variant가 좋은지 판단하기 위해, tactic-level structure뿐 아니라 capability dependency 관점의 정합성까지 보려고 했다.
이것이 AEP 도입의 핵심 이유다.
7. L1/L2/L3: variant quality를 단계적으로 나누다
MuCamp2에서는 validation을 L1, L2, L3로 나누었다.
이렇게 나눈 이유는 단순하다.
TTP variant의 품질은 하나의 숫자로 바로 판단하기 어렵다. 어떤 variant는 tactic order는 맞지만 capability dependency가 약할 수 있고, 어떤 variant는 dependency는 어느 정도 맞지만 goal tactic이 훼손될 수 있다.
그래서 quality를 단계적으로 보았다.
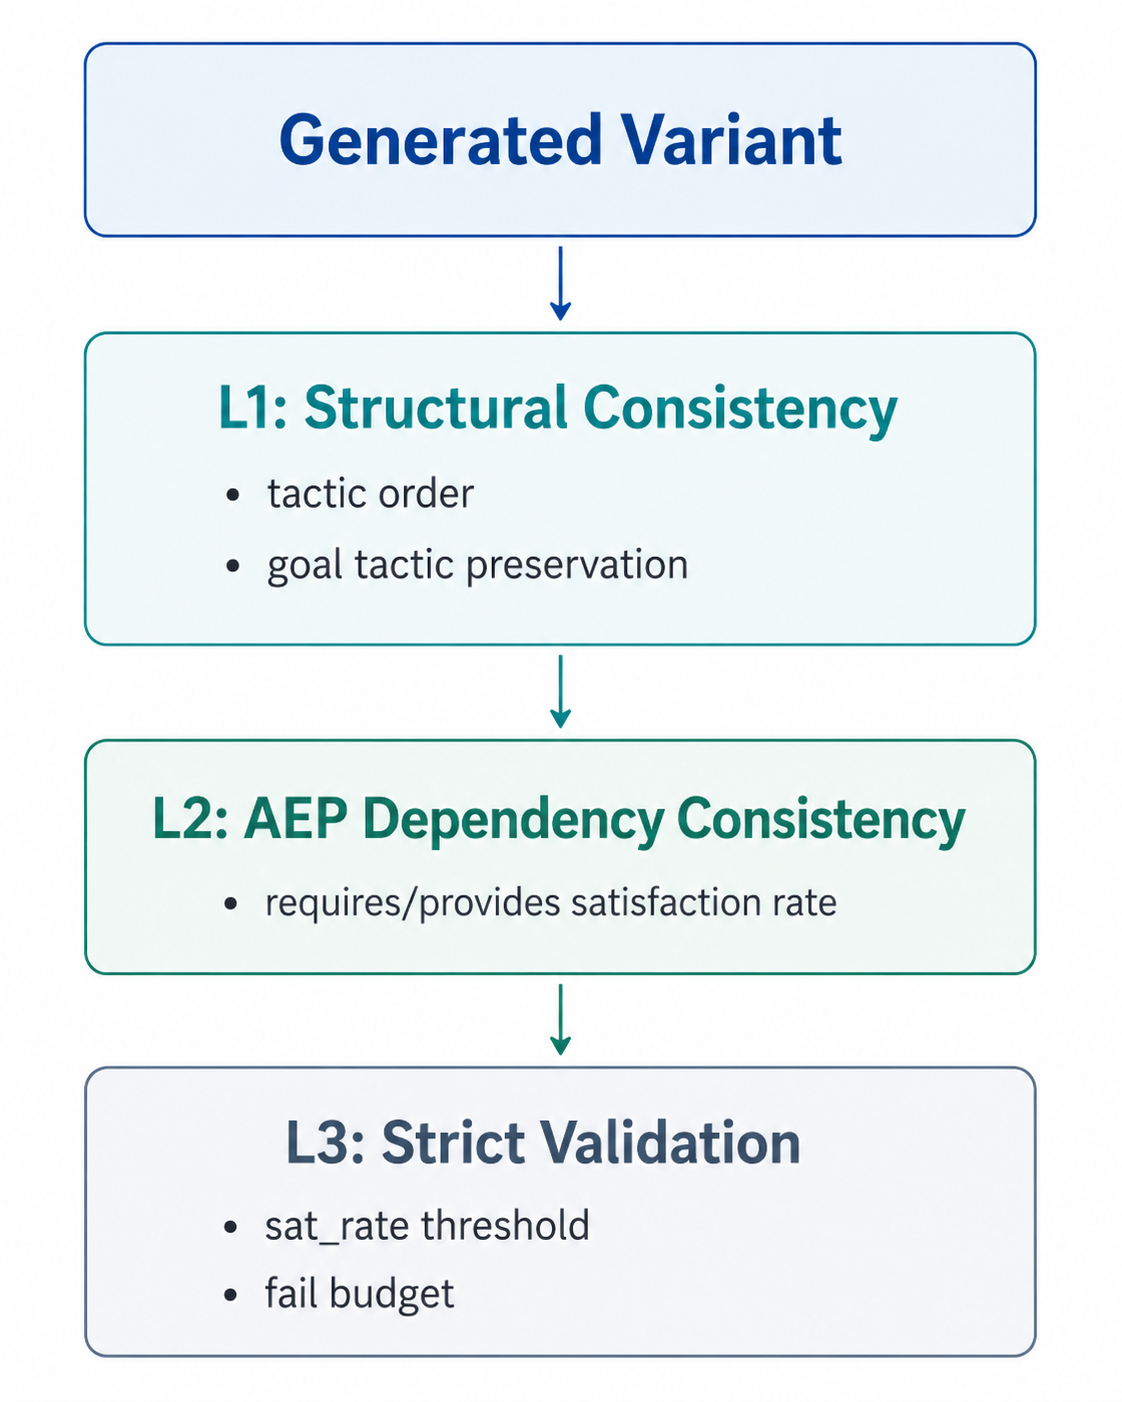
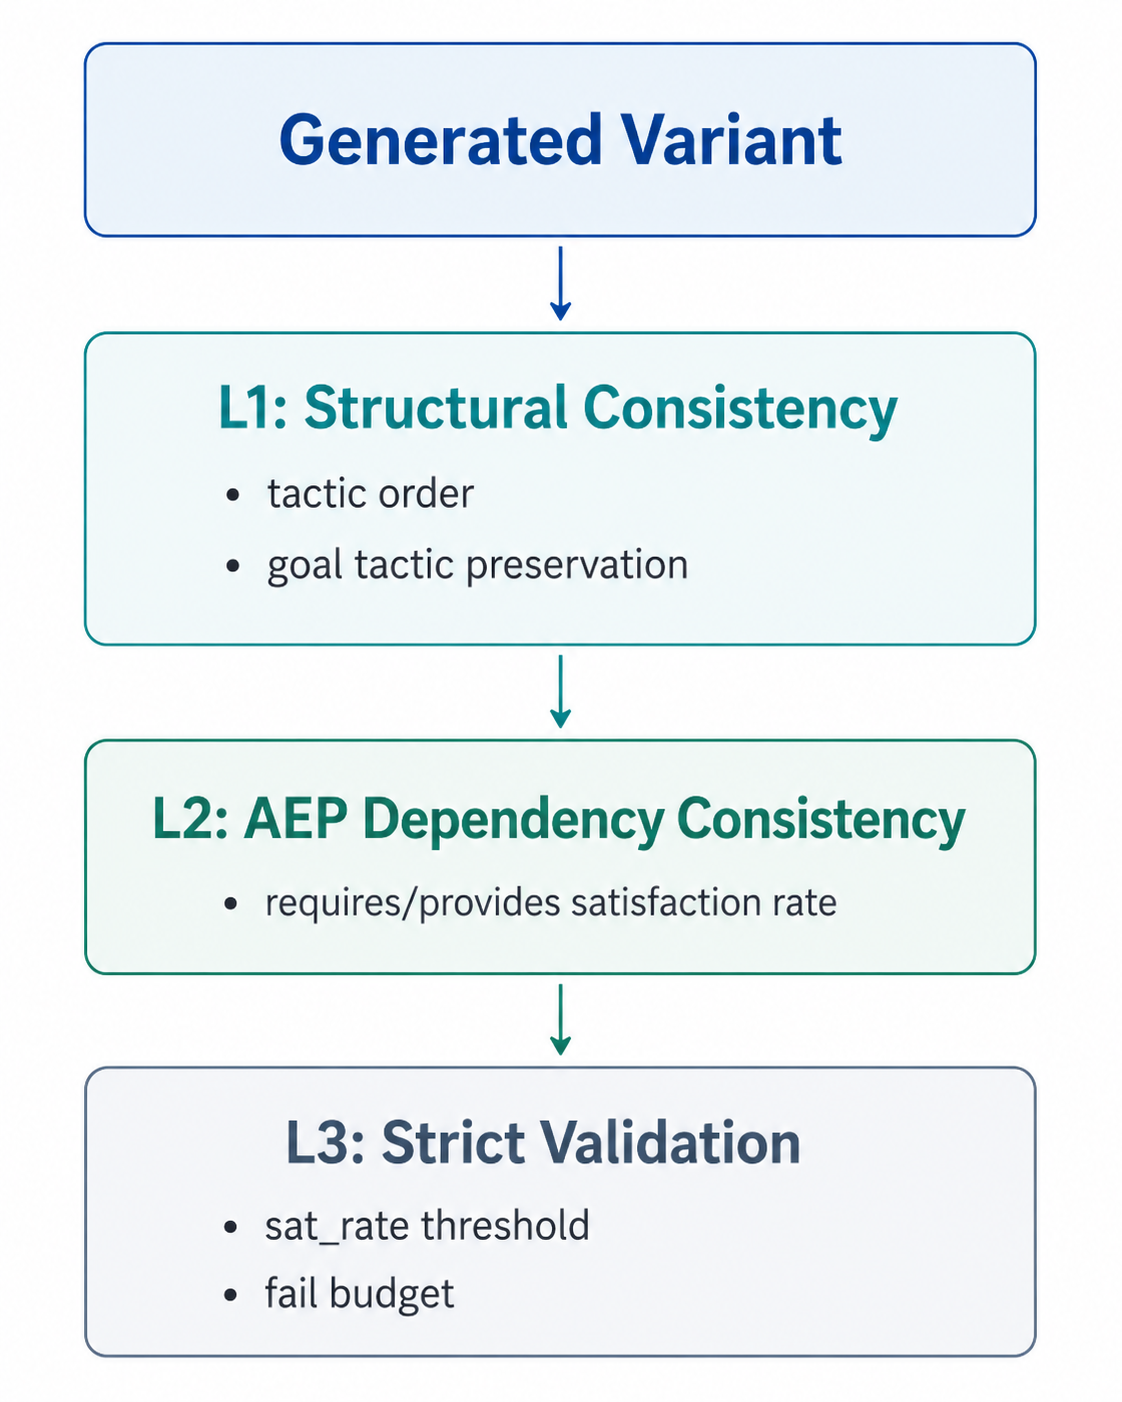
L1: Structural consistency
L1은 가장 기본적인 campaign-level structural validation이다.
L1에서는 크게 두 가지를 본다.
1. tactic order가 깨지지 않았는가
2. seed에 있던 goal tactic이 variant에도 유지되는가
즉 L1은 “이 variant가 최소한 campaign sequence로서 구조적으로 말이 되는가”를 본다.
여기서 중요한 것은 goal tactic preservation이다.
MuCamp2에서는 Collection, Exfiltration, Impact를 goal tactic으로 보았다. 이들은 campaign의 최종 목적과 연결된다. 따라서 variant를 만들 때도 이 goal tactic은 보존되어야 한다.
예를 들어 원본 campaign이 Collection과 Exfiltration을 포함한다면, variant에서도 이 전략적 목표가 유지되어야 한다. 그렇지 않으면 단순히 TTP sequence가 달라진 것이 아니라 campaign identity 자체가 바뀐 것에 가깝다.
L2: AEP-based dependency consistency
L2는 AEP의 requires/provides 정보를 이용해 sequence의 dependency consistency를 본다.
간단히 말하면, sequence를 앞에서부터 보면서 현재까지 확보된 capability가 다음 technique의 requires를 만족하는지 확인한다.
초기 capability set을 둔다.
sequence를 앞에서부터 순회한다.
각 technique의 requires가 현재 capability set으로 만족되는지 확인한다.
만족되면 satisfied로 본다.
만족되지 않으면 fail로 기록한다.
각 technique의 provides를 capability set에 추가한다.
L2에서는 requirement satisfaction rate를 사용한다. 기본 threshold는 0.7이다.
즉 모든 dependency가 100% 만족되어야 통과하는 것은 아니다.
그 이유는 현실적이다.
첫째, AEP mapping이 모든 technique을 완전하게 cover하지 않는다.
둘째, CTI report는 실제 공격의 모든 precondition을 상세히 기술하지 않는다.
셋째, ATT&CK technique 자체가 추상화된 표현이기 때문에, 모든 operational dependency를 형식적으로 판단하기 어렵다.
따라서 L2는 formal proof가 아니라 operational consistency proxy다.
L3: Strict validation
L3는 L2보다 더 엄격한 기준이다.
L3에서는 satisfaction rate뿐 아니라 fail budget도 본다.
L3 pass = sat_rate ≥ 0.7 AND unsatisfied requirements ≤ 1
즉 전체 satisfaction rate가 기준 이상이더라도, unsatisfied requirement가 너무 많으면 통과하지 못한다.
L3는 MuCamp2에서 strict AEP-based validation의 핵심 지표로 사용된다.
다만 L3도 절대적 정답은 아니다. AEP coverage가 제한적이기 때문에, L3는 “AEP가 볼 수 있는 범위 안에서의 operational consistency proxy”로 해석해야 한다.
이 지점은 뒤에서 다시 중요해진다.
8. MuCamp2 pipeline: SR을 LLM으로 바꾸되, 평가 가능한 구조로 만든다
MuCamp2의 전체 흐름은 다음과 같다.
Seed TTP Sequence
    ↓
ATT&CK v18 Mapping / Filtering / Sorting
    ↓
Mutation Position Selection
    ↓
Candidate Pool Construction
    ↓
LLM-based Constrained Mutation
    ↓
Code-level Verification
    ↓
AEP-based L1/L2/L3 Validation
    ↓
Validated TTP Variants
    ↓
Downstream Group Attribution
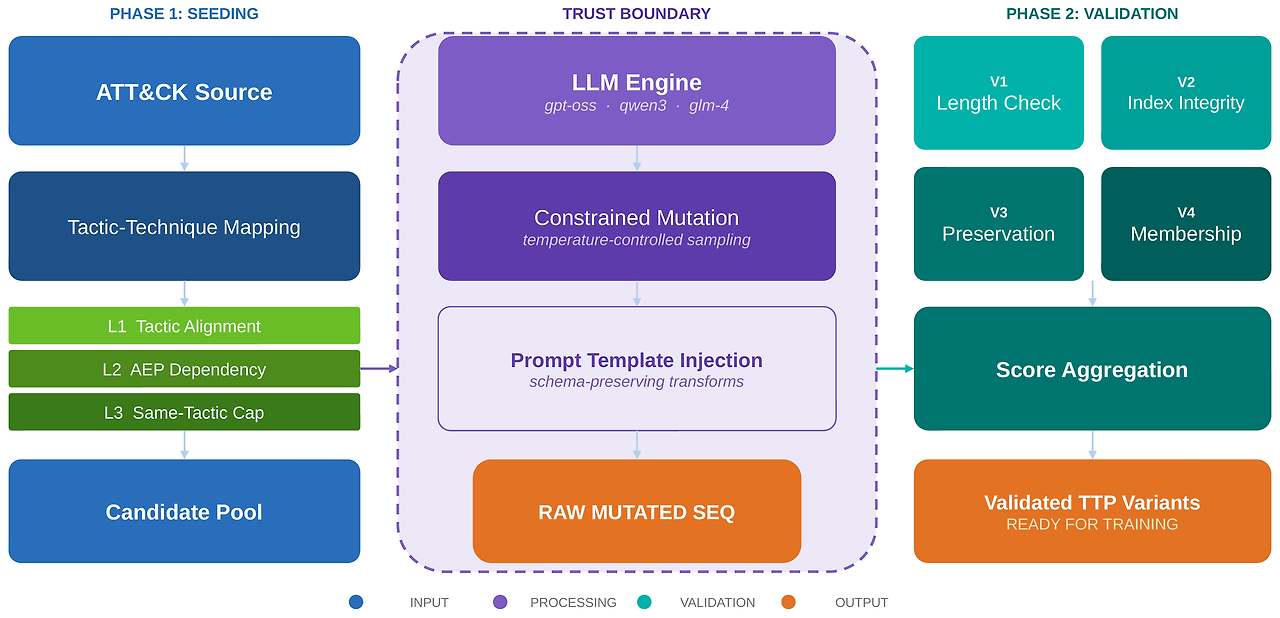
MuCamp2 전체 파이프라인
여기서 핵심은 LLM이 모든 것을 자유롭게 생성하지 않는다는 점이다.
MuCamp2는 먼저 mutation position을 정한다. 그리고 각 mutation position에서 선택할 수 있는 candidate pool을 만든다. 이 candidate pool은 같은 tactic에 속한 technique들을 기반으로 구성된다. 원래 technique은 제외된다.
LLM의 역할은 이 candidate pool 안에서 replacement를 선택하는 것이다.
즉 LLM은 “새로운 공격 campaign을 만들어라”라는 요청을 받는 것이 아니다.
더 정확히는 다음과 같은 제한된 문제를 푼다.
이 seed sequence에서 지정된 position만 바꾸되,
각 position마다 허용된 candidate pool 안에서만 replacement를 선택하고,
나머지 position은 그대로 유지한 JSON을 반환하라.
이렇게 설계한 이유는 LLM output을 평가 가능하게 만들기 위해서다.
LLM이 자유롭게 sequence를 만들면, 그 output이 왜 좋은지 판단하기 어렵다. 반면 mutation position, candidate pool, output schema를 제한하면, 적어도 어떤 위치에서 어떤 후보로 바뀌었는지 추적할 수 있다.
즉 MuCamp2는 LLM을 넣되, LLM output을 검증 가능한 형태로 제한했다.
9. GitHub 공개: 논문에서 끝나는 게 아니라 재현 가능한 형태로 남기기
MuCamp2는 논문만 있는 것이 아니라 GitHub repository도 공개되어 있다.
Repository: https://github.com/cyailab/MuCamp2
논문을 쓰면서 중요하게 생각했던 것 중 하나는, 결과를 단순히 논문 표와 문장으로만 남기지 않는 것이었다. 특히 MuCamp2는 단순 모델 제안이라기보다, TTP sequence preprocessing, SR baseline generation, LLM-based mutation, code-level verification, AEP-based L1/L2/L3 validation, downstream attribution evaluation이 이어지는 pipeline이다.
이런 연구는 논문만 읽으면 전체 구조는 이해할 수 있어도, 실제로 어떤 데이터가 들어가고 어떤 스크립트가 어떤 순서로 실행되는지 감이 잘 안 올 수 있다.
그래서 GitHub에는 다음과 같은 요소들을 포함했다.
MuCamp2/
├── scripts/      # generation, validation, evaluation, analysis scripts
├── data/         # source report list, seed sequences, ATT&CK mapping, AEP data
├── dataset/      # script compatibility mirror
├── aep-data/     # AEP requires/provides mapping
├── figures/      # paper figures
├── gui/          # MuCamp2 Attack Variant Workbench
├── Dockerfile
├── docker-compose.yml
└── README.md
이 repository가 중요한 이유는 단순히 “코드를 공개했다”가 아니다.
MuCamp2의 핵심은 결국 “LLM이 만든 variant의 품질을 어떻게 검증할 것인가”에 있다. 이 검증 과정은 말로만 설명하면 추상적으로 보일 수 있다. 하지만 실제 script와 data structure를 보면, V1–V4 code-level verification과 L1/L2/L3 semantic validation이 어떤 식으로 분리되어 있는지 더 명확하게 볼 수 있다.
예를 들어 repository에는 SR baseline generation, LLM few-shot variant generation, variant evaluation, downstream attribution, learning curve analysis, L1/L3 failure analysis, AEP coverage bias analysis 같은 스크립트들이 포함되어 있다.
개인적으로는 이 부분이 꽤 중요하다고 생각한다.
논문은 연구의 결과를 정리한 문서라면, GitHub는 그 연구가 실제로 어떤 형태로 구현되었는지 보여주는 기록이다. 특히 보안과 AI가 만나는 연구에서는 “그럴듯한 아이디어”보다 “어떤 constraint를 코드로 강제했고, 어떤 validator를 통과한 결과만 남겼는가”가 중요하다.
MuCamp2에서 말하는 핵심도 결국 여기에 가깝다.
LLM output을 곧바로 믿지 않는다.
검증 가능한 구조로 제한한다.
검증을 통과한 variant만 downstream task에 사용한다.
GitHub repository는 이 구조를 논문 밖에서도 확인할 수 있게 해주는 산출물이다.
또 하나 재미있는 점은 GUI도 포함되어 있다는 것이다. MuCamp2 Attack Variant Workbench를 통해 seed TTP sequence를 선택하거나 직접 입력하고, SR/LLM variant를 replay하고, original vs mutated ATT&CK timeline을 비교하며, L1/L2/L3 validation과 AEP requires/provides trace를 확인할 수 있다.
즉 이 repository는 단순히 실험 스크립트만 모아둔 것이 아니라, MuCamp2의 핵심 아이디어인 “generation 이후 validation”을 직접 확인할 수 있는 형태로 구성되어 있다.
논문을 읽는 것과 코드를 보는 것은 다르다.
논문에서는 왜 이런 구조가 필요한지 설명하고,
GitHub에서는 그 구조가 실제로 어떻게 구현되어 있는지 확인할 수 있다.
그래서 MuCamp2를 이해하려면 논문과 GitHub를 같이 보는 편이 좋다.
10. Code-level verification: LLM output은 일단 믿지 않는다
LLM output은 바로 variant로 인정되지 않는다.
먼저 V1–V4 code-level verification을 통과해야 한다.
| Gate | 검증 항목 | 의미 |
| V1 | Length match | seed와 output sequence 길이가 같은가 |
| V2 | Index consistency | LLM이 바꾼 index가 사전에 지정된 mutation set과 같은가 |
| V3 | Non-mutated preservation | mutation 대상이 아닌 position이 그대로 유지됐는가 |
| V4 | Candidate pool membership | 바뀐 technique이 허용된 candidate pool 안에 있는가 |